小鹏AI Day|End to End 的范式可能成为共识
在小鹏 AI Day发布会上,IRON 机器人由于其走路姿势非常接近人的姿态获得媒体关注度很高,具身机器人固然重要,但其发布会的前半部分关于 VLA 更值得关注。
为了让大模型做到真正的 End to End,小鹏的技术路径选择了砍掉了 Language 这个环节。
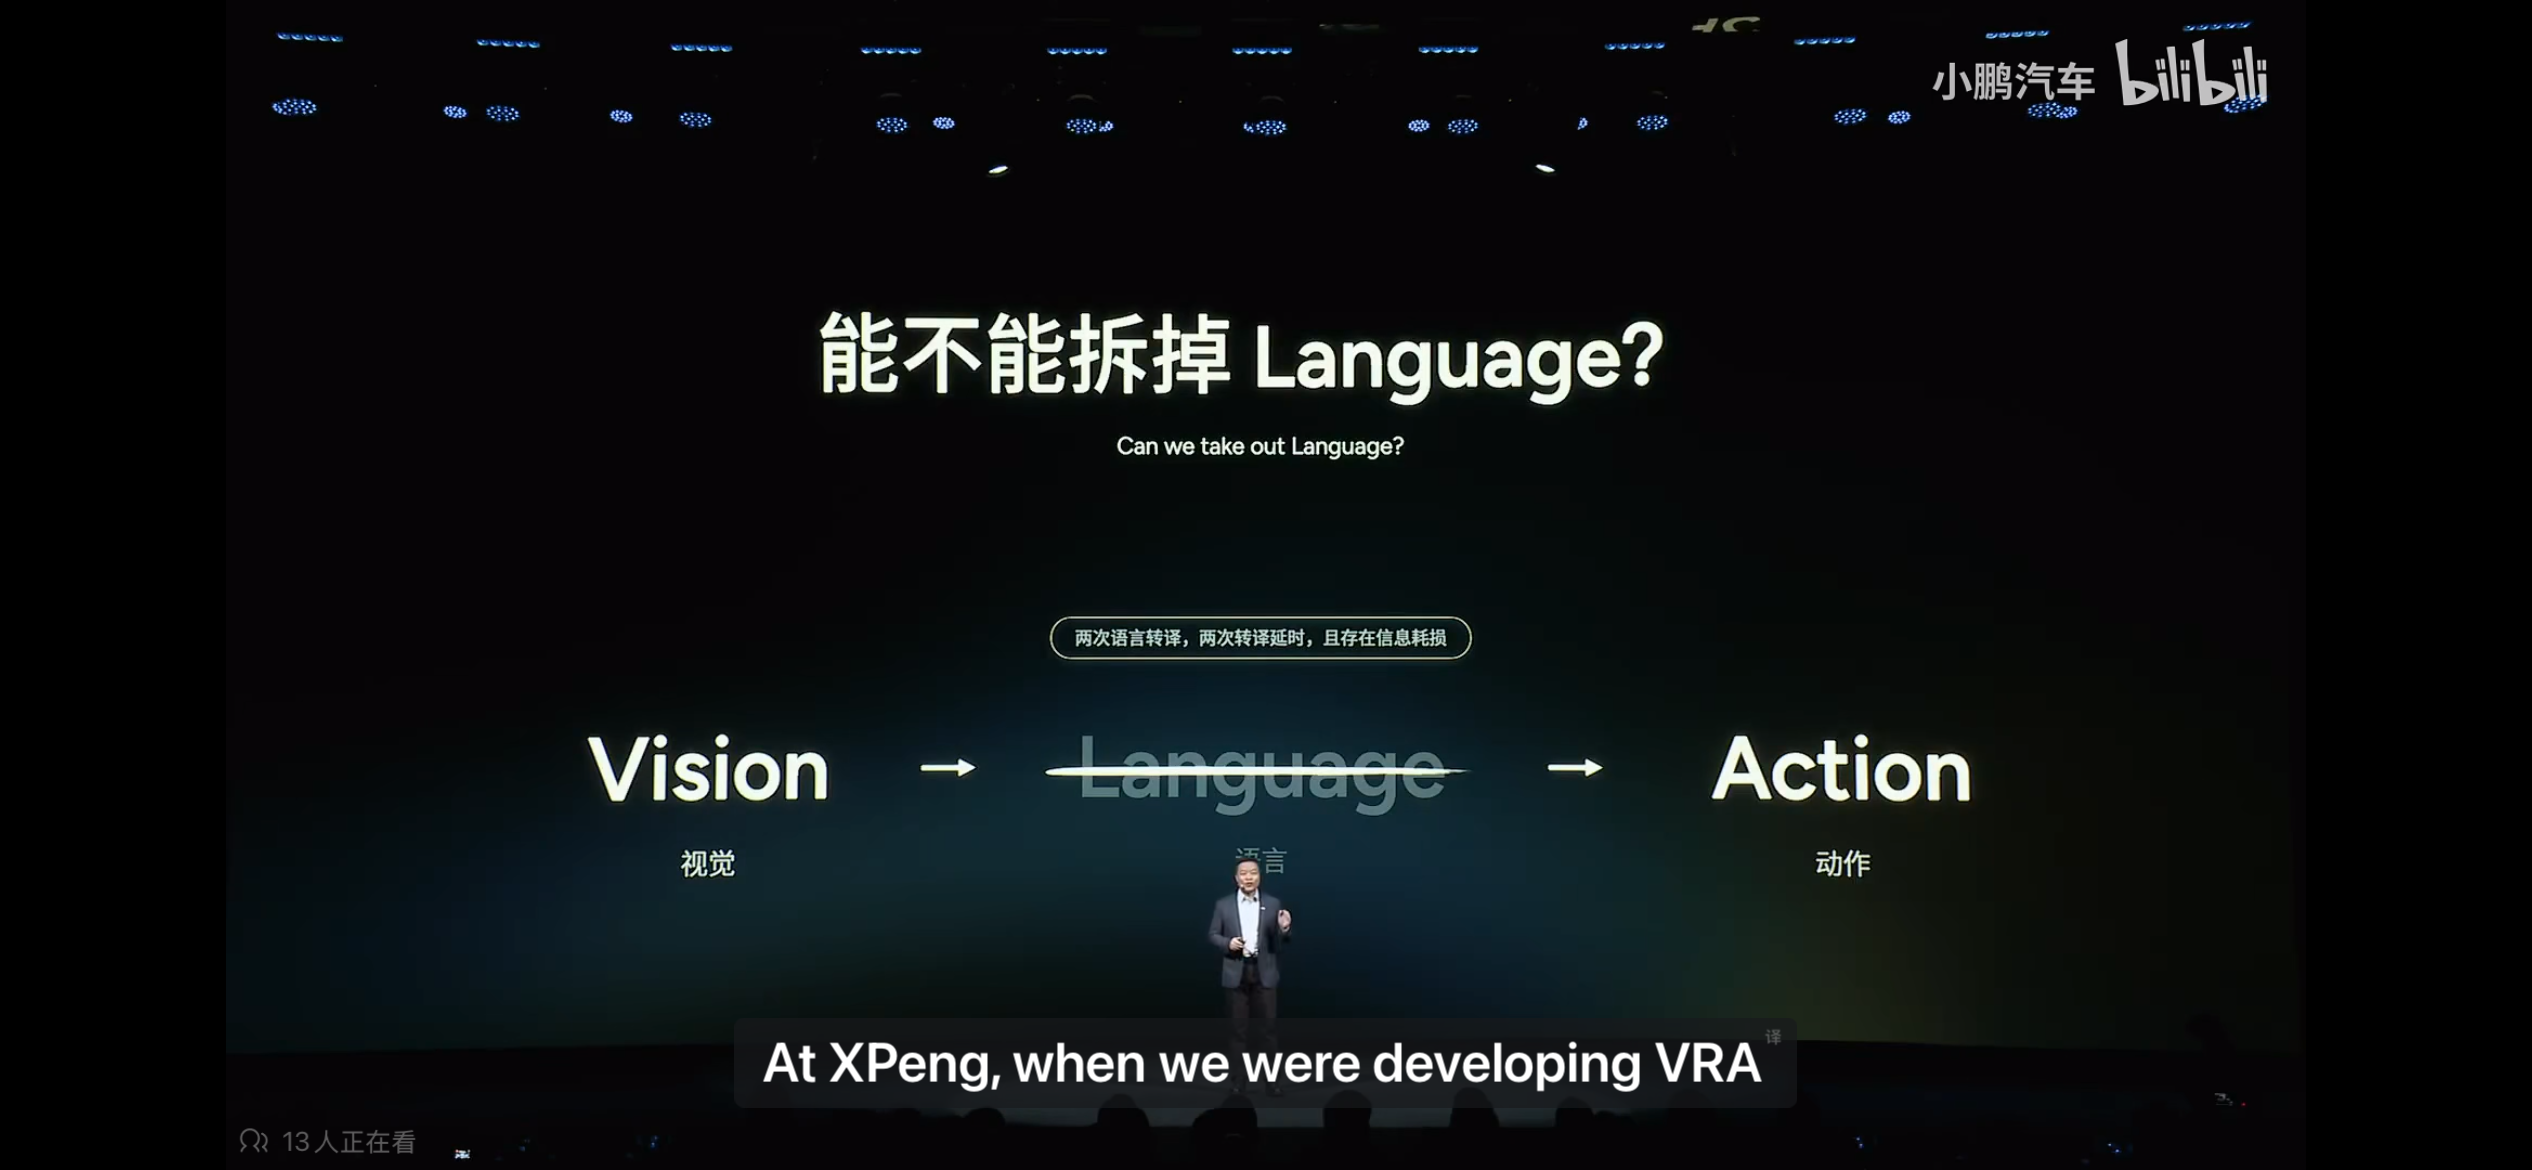
这个技术路线是非常反直觉的(技术本身就倾向于控制而不是放手让概率统计来决定安),放弃中间的 Language 环节,小鹏说其智能辅助驾驶模型出现了涌现(Emerge)现象,在具体使用过程中很多 Corner Data 情况不需要工程师预设规则来处理,新的 VA 模型本身能很自然处理这种边界情况(甚至是工程师没预设规则的场景),期待明年小鹏智能辅助驾驶真正 OTA 升级后实战反馈吧。
这种技术路线风险比较高,决策层需要有耐心,要有技术远见能够保证持续地投入(也有可能特斯拉已经验证了这条路线的可行性),新的 VA 模型小鹏训练也投了 20 多亿美金才看到了涌现现象。
不知道这种 End to End 会不会逐渐成为行业共识。
在今年年初,李想在播客节目上说用 DeepSeek 推理模型优化其 Language 环节,没想到年底了小鹏说这个 Language 环节我们不需要了,这个世界真的变化很快。
小鹏在发布会上一直强调智能辅助驾驶更丝滑了,可能有以下收益:
- 延迟问题:直接看到世界并且给出动作,比中间多一层 Language 描述要更加有效率,时延减少了。
- 信息损失:使大模型像人一样直接学习认识世界,大幅降低信息损耗,推理效率更高,反应更快。
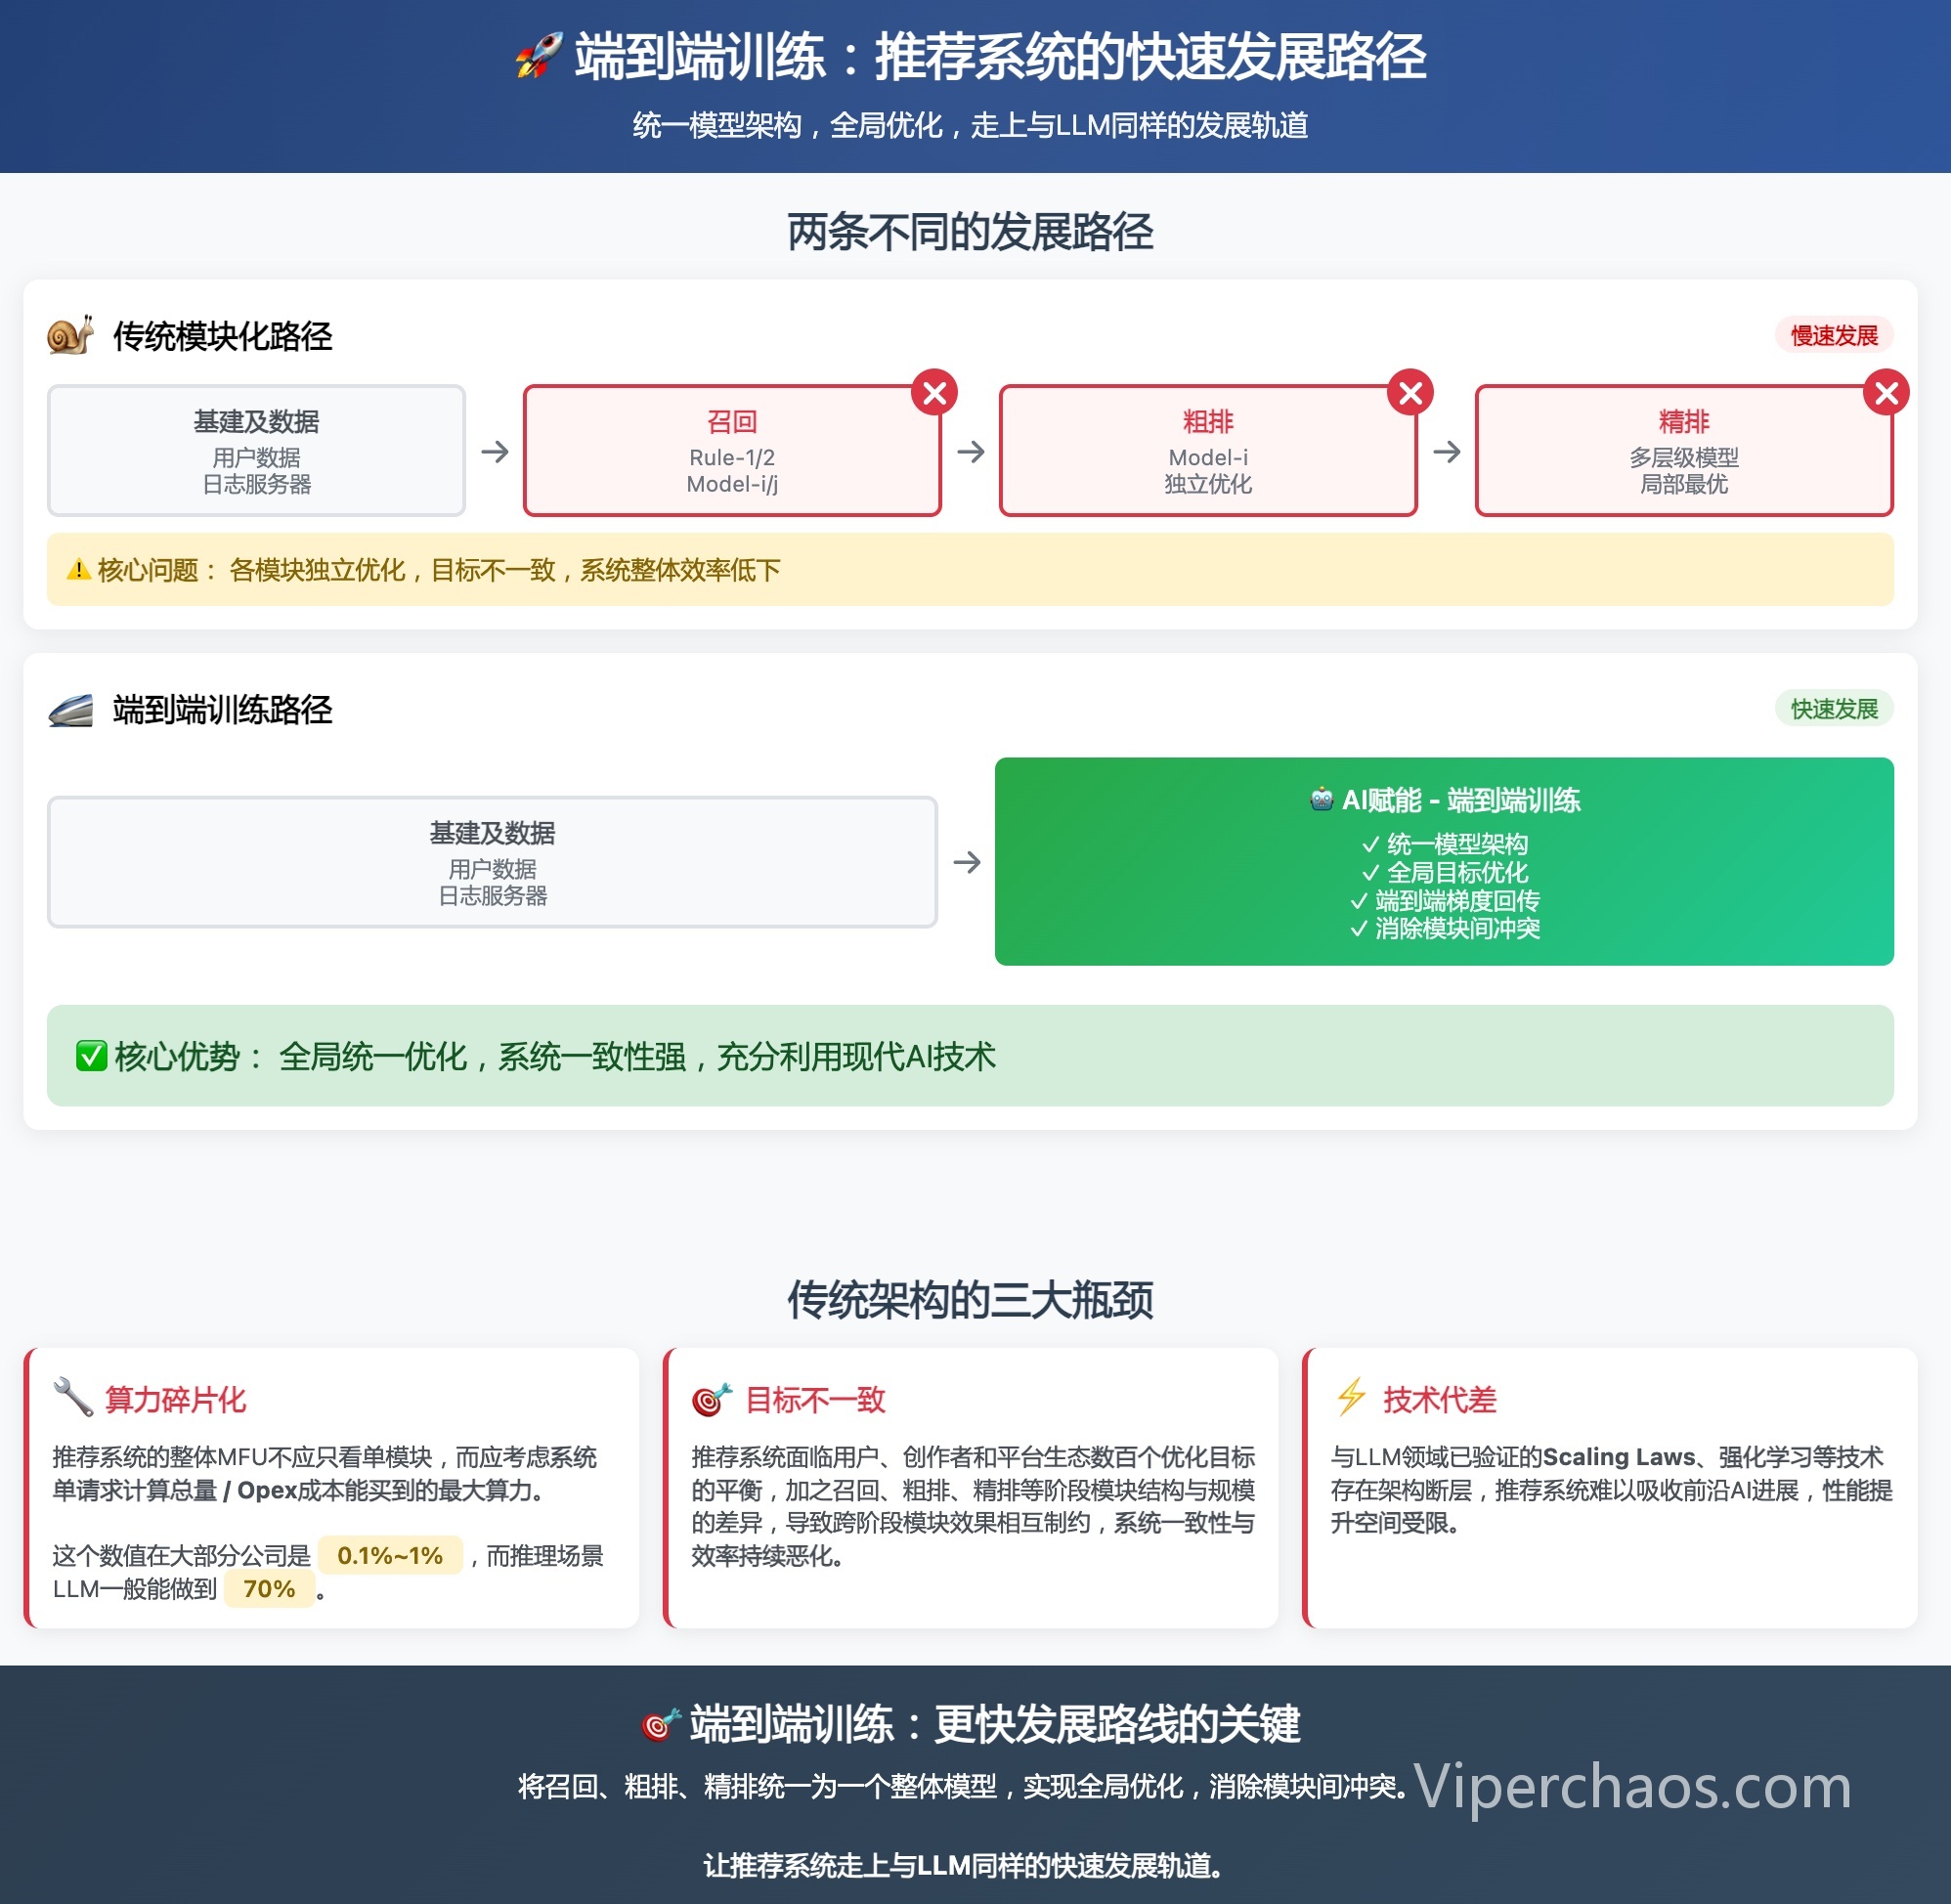
前段时间也看到快手的推荐模型准备放弃传统「召回—粗排—精排」的做法,直接基于 End to End 去训练数据方式来重新做推荐模型,最大化挖掘硬件的算力价值。
另外一个案例就是 DeepSeek OCR 解决方式,也是类似的做法。
传统的 OCR:
图像 → 文字检测(找到文字框) → 文字识别(识别每个字) → 文本token(逐字转换)
DeepSeek 的做法:
图像 → 视觉压缩(整体理解) → 视觉token (几百个token) → LLM解码(理解输出) → 文本
感兴趣的可以搜「DeepSeek-OCR:Contexts Optical Compression」这篇论文。
也许 Transformer 这套架构就是基于最原始的信息做最终的输出,至于中间是否 Language Model 不重要了。